Начало теории. Алгоритмы и ИИ. Нейронные сети и LLM. Обучение
До существования ИИ, наши программы решали проблемы, которые поддаются какому-то чёткому алгоритму, который можно выделить, определить и применить.
Но с приходом ИИ, мы уже можем выполнять задачи, которые требуют человеческого интеллекта:
- Распознавание изображений
- Перевод
- Анализ текста
- Генерация звука
По уровням можно разбить:
- Искусственный интеллект - самая широкая система, которая включает в себя всё
- Машинное обучение - правила мы не прописываем вручную, а они формируются на основе закономерностей из предоставленных данных
- Deep learning - на базе многослойных сетей уже система сама достаёт определённые признаки
- Нейронная сеть - конкретная архитектура модели
- LLM - нейронная сеть, которая обучена на огромном количестве данных
Нейронные сети
Слои:
- Входной - принимает входные данные
- Скрытый - вычисляет скрытые представления
- Выходной - формирует итоговый результат (представление)
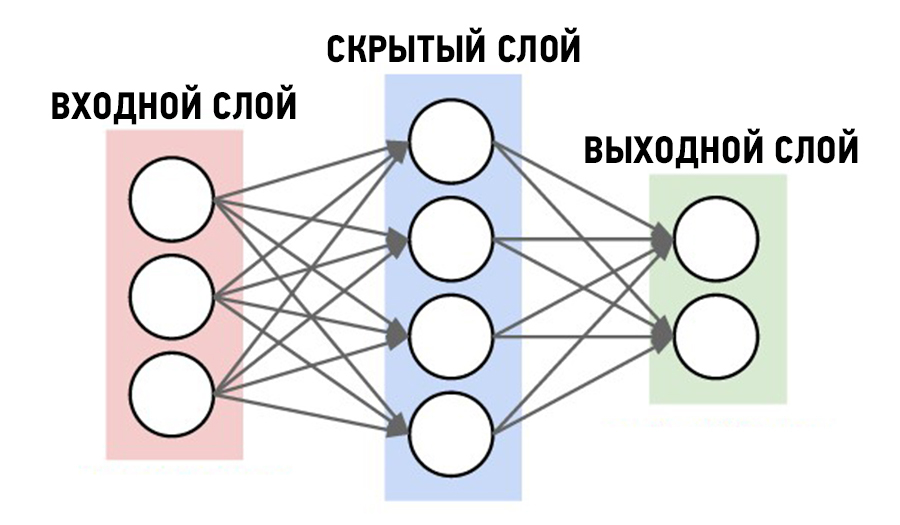
Количество параметров модели нам говорит о том, что в ней определённое количество сформированных весов
Обучение
Само по себе обучение моделей итеративное и повторяется в данной последовательности:
- DataSet
- Модель
- Предсказание
- Сравнивается с ответом
- Меняет параметры
LLM как чистая функция. Токены, распределение вероятностей и температура. Векторы (embeddings)
LLM можно рассматривать, как чистую функцию. При одинаковых входных данных всегда должен быть одинаковый ответ на выходе.
На вход подаются токены, а на выходе мы получаем распределение.
Распределение может выглядеть следующим образом:
- 0.40 - шить - самый вероятный вариант, который подставится в ответ
- 0.20 - бежать
- 0.10 - прыгать
- 0.5 - смотреть
- 0… - остальные варианты
Токены
Что такое javascript?
Одна определённая фраза - это промпт в ИИ.
Промпт состоит из токенов, которые составляют из себя последовательность символов. Каждому токену присваивается свой индекс, по которому будет идти взаимодействие. Каждому идентификатору присваивается вектор, который называется embedding.
[что]- id 58 -[0.16,0.32,0.06...][такое]-[java]-[script]-
Вектора позволяют сохранять смыслы: авто, тачка, машина, автомобиль - скорее всего будут близки по смыслу. Телефон уже не будет входить в эту последовательность.
Расположение векторов формируется во время обучения модели.
Таким образом у нас складывается последовательность:
- промпт
- токены
- нейросеть
- предсказание следующего токена
- токен добавляется к тексту (
шить) - повторяется несклько раз
Однако из-за такого цикла нельзя воспринимать LLM, как чистую функцию, так как в ней присутствует этап предсказания следующего токена, которое рандомизирует выборку.
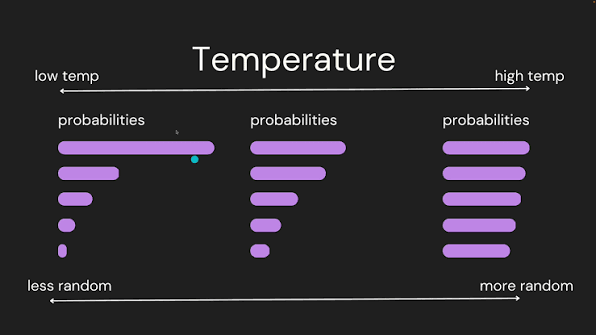
Однако это можно регулировать за счёт параметра T - temperature. Она определяет уровень творчества и чем ближе к 0 будет параметр, тем меньше творчества будет в ответах.
Так же на рандомизацию значения вляет seed.
Чем выше температура, тем больше сглаживается вероятность использования всех появившихся токенов
Контекст и контекстное окно. Переполнение и оптимизация.
Контекст - это последовательность токенов, которая доступа модели в определённый момент времени.
В контекст попадают наши промпты, системные промпты, данные окружения, полученная в ходе работы информация.
Контекстное окно - это то, сколько контекста может хранить LLM.
С одной стороны, чем больше контекста по задаче мы описали, тем точнее будет наш результат. Но с другой стороны, чем больше отвлекающих и мусорных данных в контексте, тем больше будет галлюцинировать модель.
Для оптимизации контекста используются:
- скользящее окно - откидываем старые токены
- саммаризация - делаем выжимку из всего контекста и сжимаем количество используемых токенов
Смысл слов. Архитектура Transformer и attention. Начало GPT
GPT - генеративный предтренированный трансформер
Основная ключевая мысль ИИ заключается в понимании контекста и связывании друг с другом фактов.
Какие функции НЕ входят в JS? - все токены этого слова смотрят друг на друга.
Это заслуга архитектуры Transformer.
Attention - это механизм, который позволяет определить важность и позицию отдельных слов в промпте относительно других присутствующих токенов.
RAG. Чанки, вектора, векторная БД
RAG - retrieval-augmented generation - это инструмент для поиска по нашим ресурсам (БД, документация).
Подход:
- промпт
- поиск информации
- нашли нужную информацию
- добавили в контекст
- LLM выдала ответ
Сама LLM ничего не ищет - этим занимается отдельная система
Как формируется RAG:
- У нас есть базовая Документация
- Её мы разбиваем на Чанки
- Потом формируем Вектора из Чанков
- Помещаем все данные в Векторную БД
- И за счёт этого становится возможным реализовать Векторный поиск по смыслу
Галлюцинации
Галлюцинации - это явление, когда LLM может выдывать некорректную информацию и впоследствии её защищать.
Тут нужно понимать, что LLM не мыслит в сторону того корректную или некорректную информацию она выдаёт. Она мыслит категорией того, “какой следующий токен будет более вероятным?”
Инструменты. Tool calling
В реальной жизни LLM уже взаимодействует с браузером, с файлами, с терминалом. Но сама по себе LLM этим не занимается - она просто формирует последовательность токенов.
Когда мы спрашиваем какая сегодня погода? модель может ответить либо не знаю, либо вызвать внешний инструмент, который пойдёт в интернет и достанет нужную информацию api.get("https://...")
LLM просит внешнюю систему сделать определённое нужное действие.
Внешние сервисы и MCP
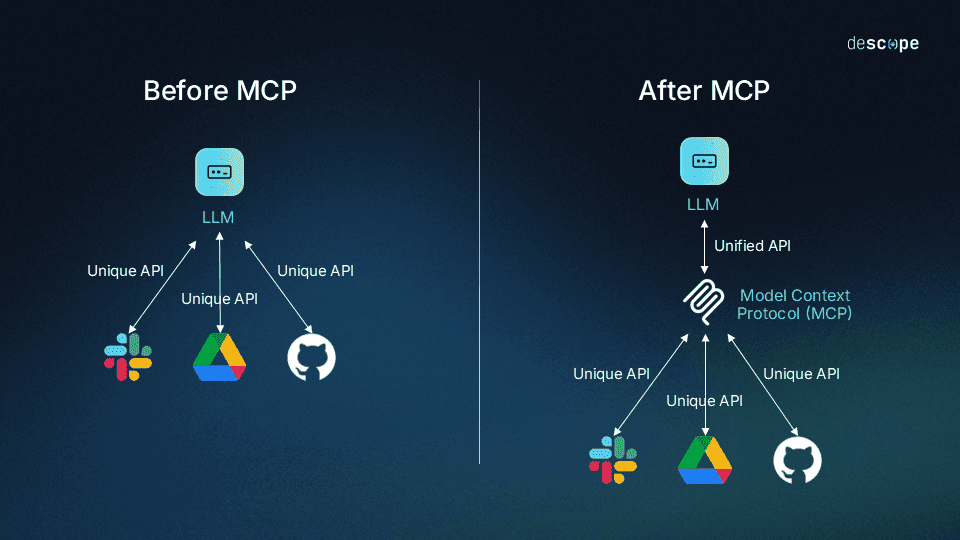
Для взаимодействие с внешними системами используется MCP.
MCP - model context protocol - это утилита, которой может пользоваться LLM, чтобы получать возможный набор операций и эффективно им пользоваться для доступа к определённой системе.
Агенты и их архитектура. Цикл Agent loop
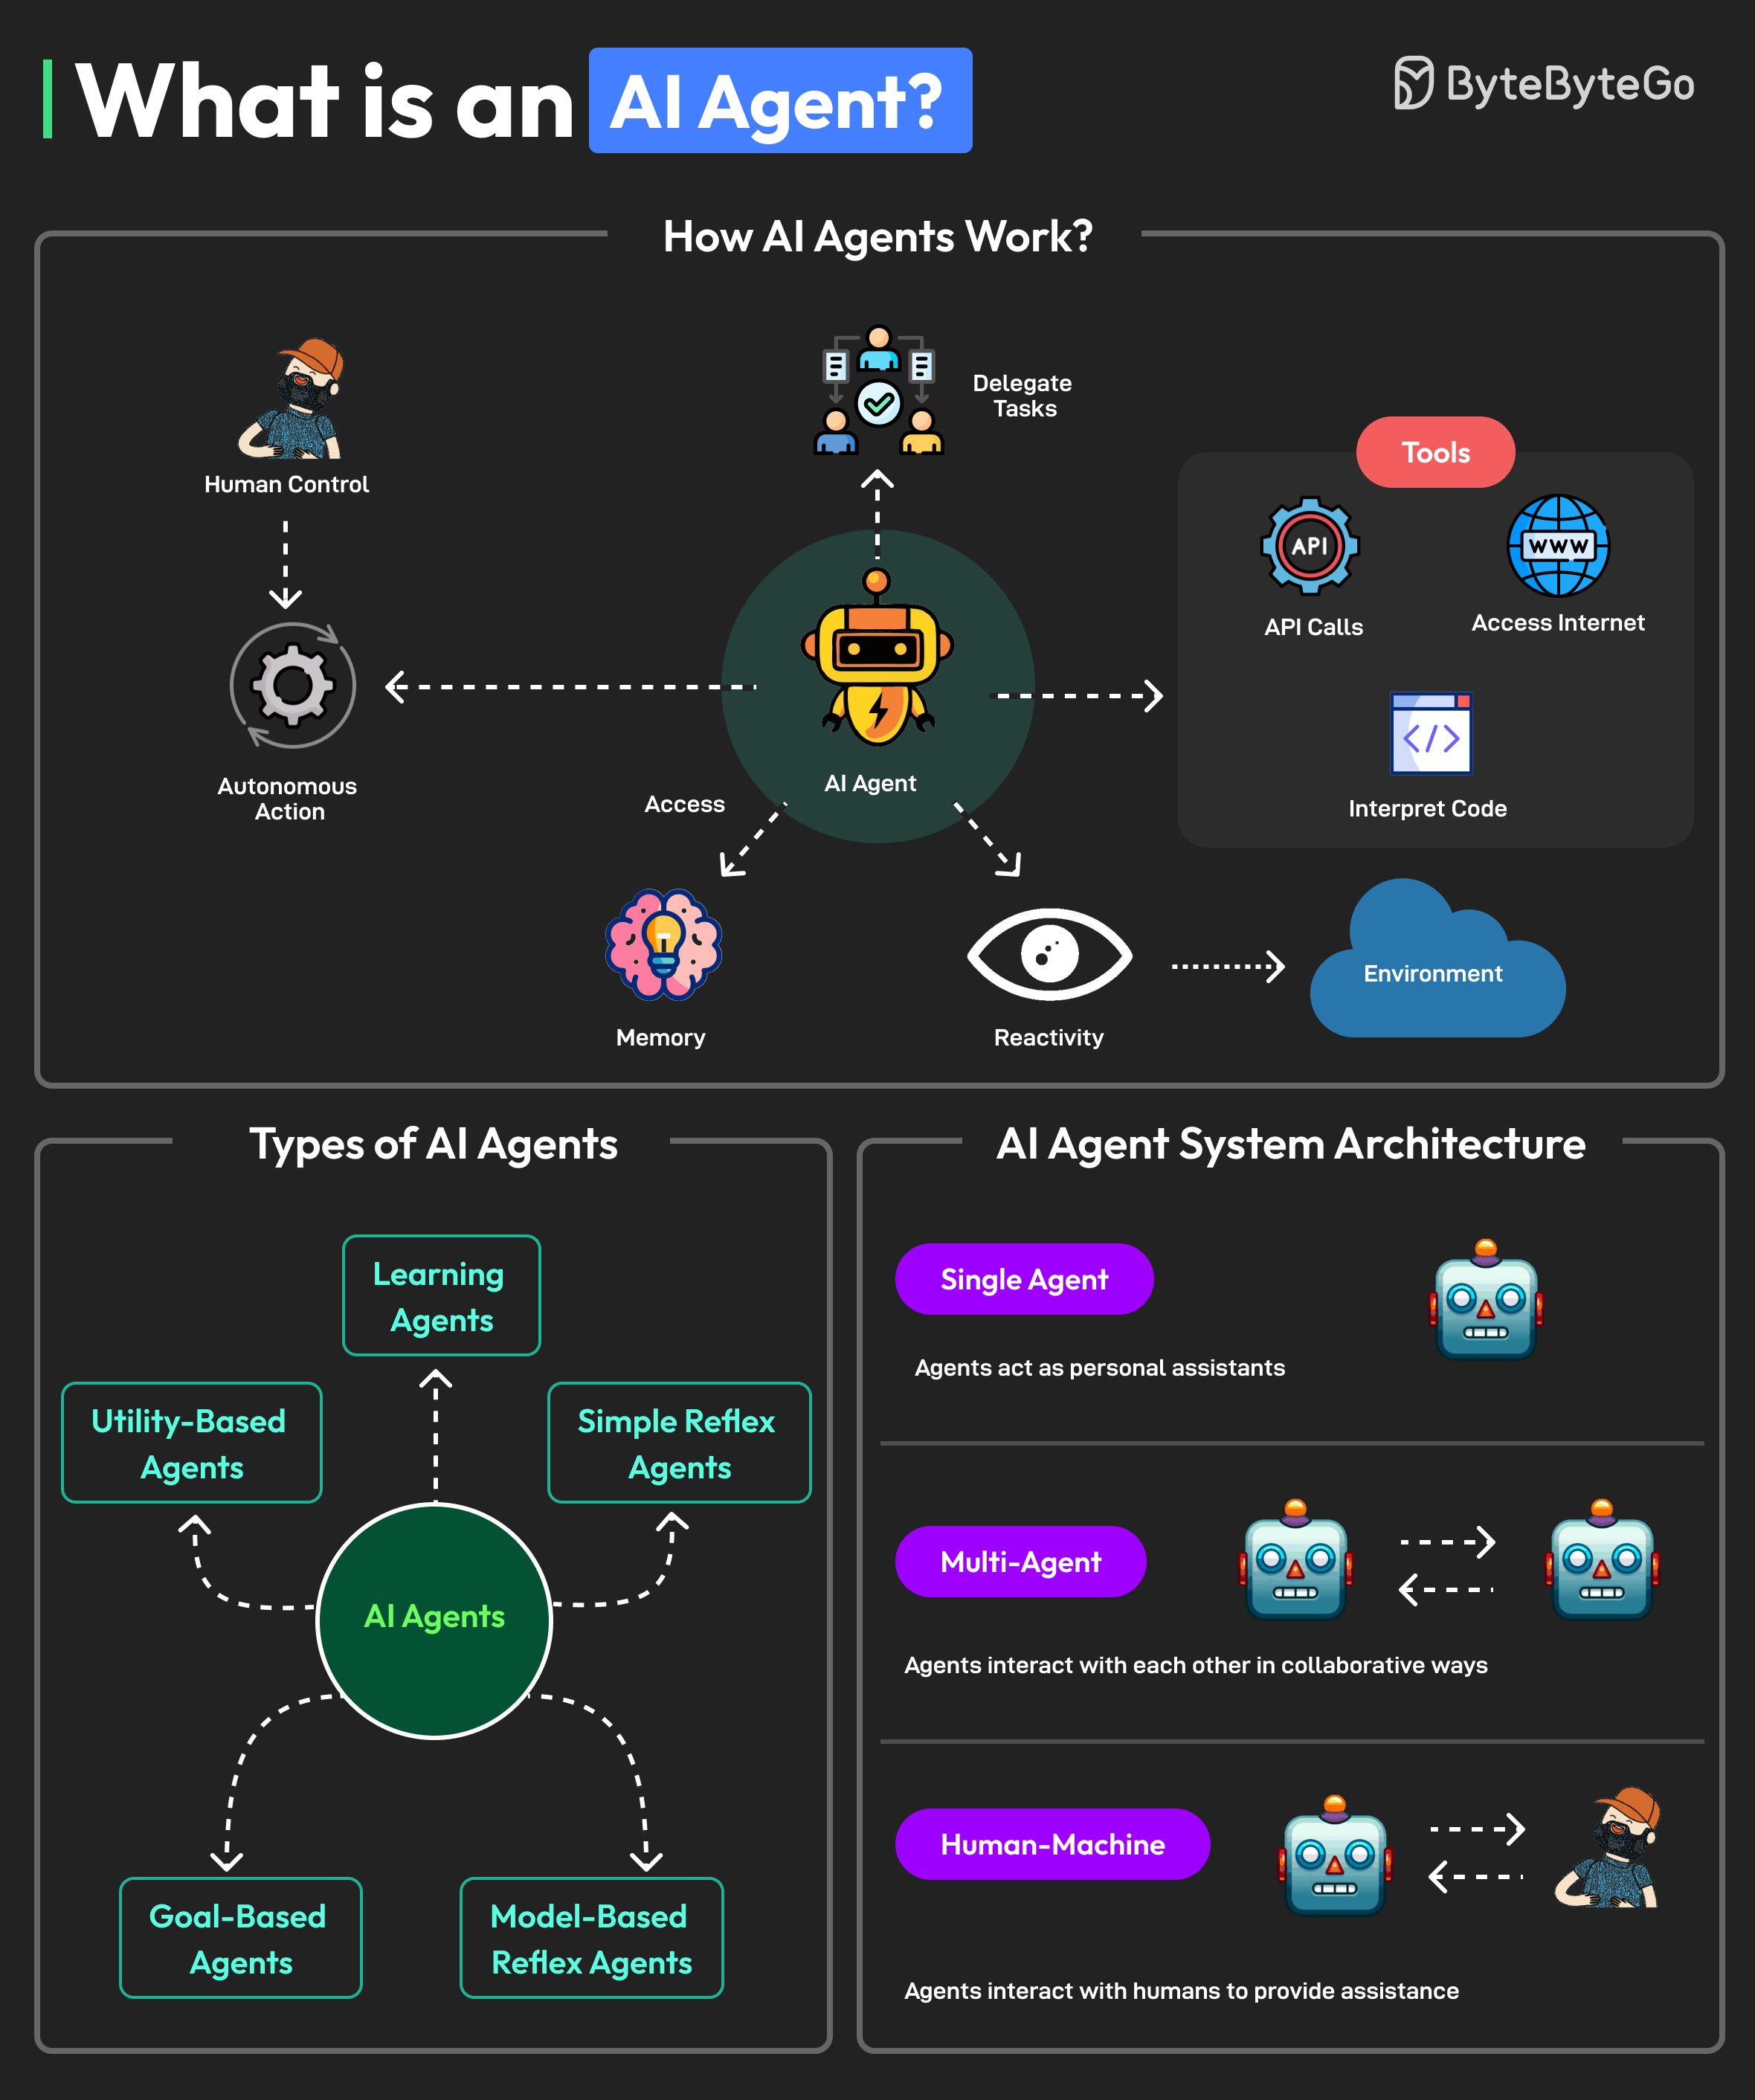
Агенты - это отдельные единицы, которые взаимодействуют с LLM
Они имеют свои:
- инструменты
- контекст
- State - технические данные о его работе
- инструкция
- цикл - думай → действуй проверяй → повторяй - agent loop - самая важная часть, которая позволяет доводить задачи до какого-то законченного результата
Агентские оболочки, Harness. Оркестрация агентами
Claude Code, Codex, Antigravity - это агентские оболочки - harness
Оркестрация - это механизм, который позволяет поднимать и управлять сразу несколькими агентами, которые выполняют свои задачи. Благодаря такому подходу мы можем собирать разных агентов под разные задачи: планировщик, исполнитель, тестировщик, ревьюер. У каждого из них будет своя задача и свой контекст, что понизит уровень галлюцинаций.
Скиллы
В рамках ИИ разработки, у нас есть переиспользуемые инструкции, которые позволяют зафиксировать определённые последовательности действий и правил.
Мы один раз описываем скилл и описываем, что агент должен делать: писать фронт с FSD архитектурой, соблюдать кодстайл, писать тесты, проводить ревью. В один момент времени лучше использовать один скилл, чтобы не перегружать контекст.
Выбор модели
Индустрия всегда предоставляет выбор - дешёвые и дорогие модели. Нам всегда нужно определять что и для чего нам нужно. Более простые задачи отдаём более дешёвым моделям, а более сложные нужно отдавать более дорогим.
Например, просьбу составить спецификацию с архитектурой реализации нового микросервиса стоит отдать модели с high reasoning. Дешёвой модели можно отдать написание кода, так как по спецификации она его напишет почти так же хорошо, как и дорогая модель.
Вайбкодинг vs AI инженеринг. Экспертиза в AI
И тут у нас стоит вопрос внимания и скорости разработки, которые нужны для решения определённых проблем. Всегда нужно соблюдать баланс в зависимости от ситуации.
| Вайбкодинг | AI инжиниринг | |
|---|---|---|
| экспертиза в разработке | Не обязательна | Обязательна |
| Экспертиза в AI | Обязательно | Опциональна |
| Цель | Прототипы, MVP, локальные проекты | Продуктовая прод разработка |
| Код ревью | Агентами | Разработчиками |
При вайбкодинге, мы НЕ смотрим на код. Это снижает скорость разработки, ради которой вайбкод и требуется.