Ментальная модель
1. Откуда взялся event-driven
Классическая разработка оперирует объектами: пользователь, заказ, товар. Объект живёт в таблице, и мы знаем только его текущее состояние. Современные системы всё чаще оперируют событиями: «заказ создан», «оплата прошла», «курьер сменил координаты». Событие — это факт, который уже произошёл и не может измениться.

Зачем это нужно бизнесу и архитектуре:
- Снижение связанности. Сервис-поставщик данных не знает, кто их потребляет. Добавили аналитику, поиск, антифрод — продюсер не меняется.
- Устойчивость к сбоям. Потребитель может лежать час; события его дождутся.
- История. Состояние — это свёртка событий. Из лога событий можно восстановить, как система пришла в текущее состояние, и переиграть обработку.
Хранить события можно и в реляционной БД, но она для этого плохо приспособлена: растущая таблица с постоянными вставками, ручной трекинг «кто что прочитал», отсутствие механизма подписки. Нужна структура, оптимизированная именно под поток событий — лог.
2. Лог
Лог — это упорядоченная во времени последовательность записей. Новая запись добавляется только в конец, уже записанное неизменяемо.

Три свойства лога, из которых следует вся Kafka:
| Свойство | Следствие |
|---|---|
| Запись только в конец | последовательный I/O — самый быстрый режим и для HDD, и для SSD |
| Записи неизменяемы | не нужны блокировки на чтение, можно отдавать байты из page cache как есть |
| Читатель сам держит позицию | несколько независимых потребителей читают один лог в своём темпе; можно перечитать историю |
Apache Kafka — это платформа, которая управляет такими логами, распределяя их по кластеру и связывая поставщиков данных с потребителями.
Kafka — не очередь. В очереди (RabbitMQ, SQS) сообщение удаляется после подтверждения; брокер следит за состоянием каждого сообщения. В Kafka сообщение живёт до истечения retention независимо от того, прочитал его кто-то или нет, а брокер хранит лишь позиции групп потребителей. Это принципиальная разница, и на собеседовании она — первый вопрос.
3. Три действующих лица
Продюсер — ваше приложение, которое пишет события. Отправил сообщение, получил подтверждение записи (acknowledgement), отправил следующее.

Брокер — процесс Kafka на машине с локальным диском. Несколько брокеров, связанных сетью, образуют кластер. Это может быть железный сервер, ВМ или под в Kubernetes.

Консумер — ваше приложение, которое читает события. Важная деталь: консумер не подписывается в push-режиме, он сам периодически поллит брокера и забирает пачку сообщений. Pull-модель — осознанное решение: потребитель сам регулирует темп и не захлёбывается, если брокер быстрее.

Ключевое свойство архитектуры: продюсер и консумер полностью изолированы. Продюсер не знает, кто и когда прочитает его сообщение, и сколько потребителей вообще существует.
4. Координация кластера: ZooKeeper → KRaft
Брокерам нужно о чём-то договариваться: кто контроллер кластера, какие есть топики и их настройки, кто лидер каждой партиции, какие ACL. Исторически для этого использовался отдельный кластер ZooKeeper.
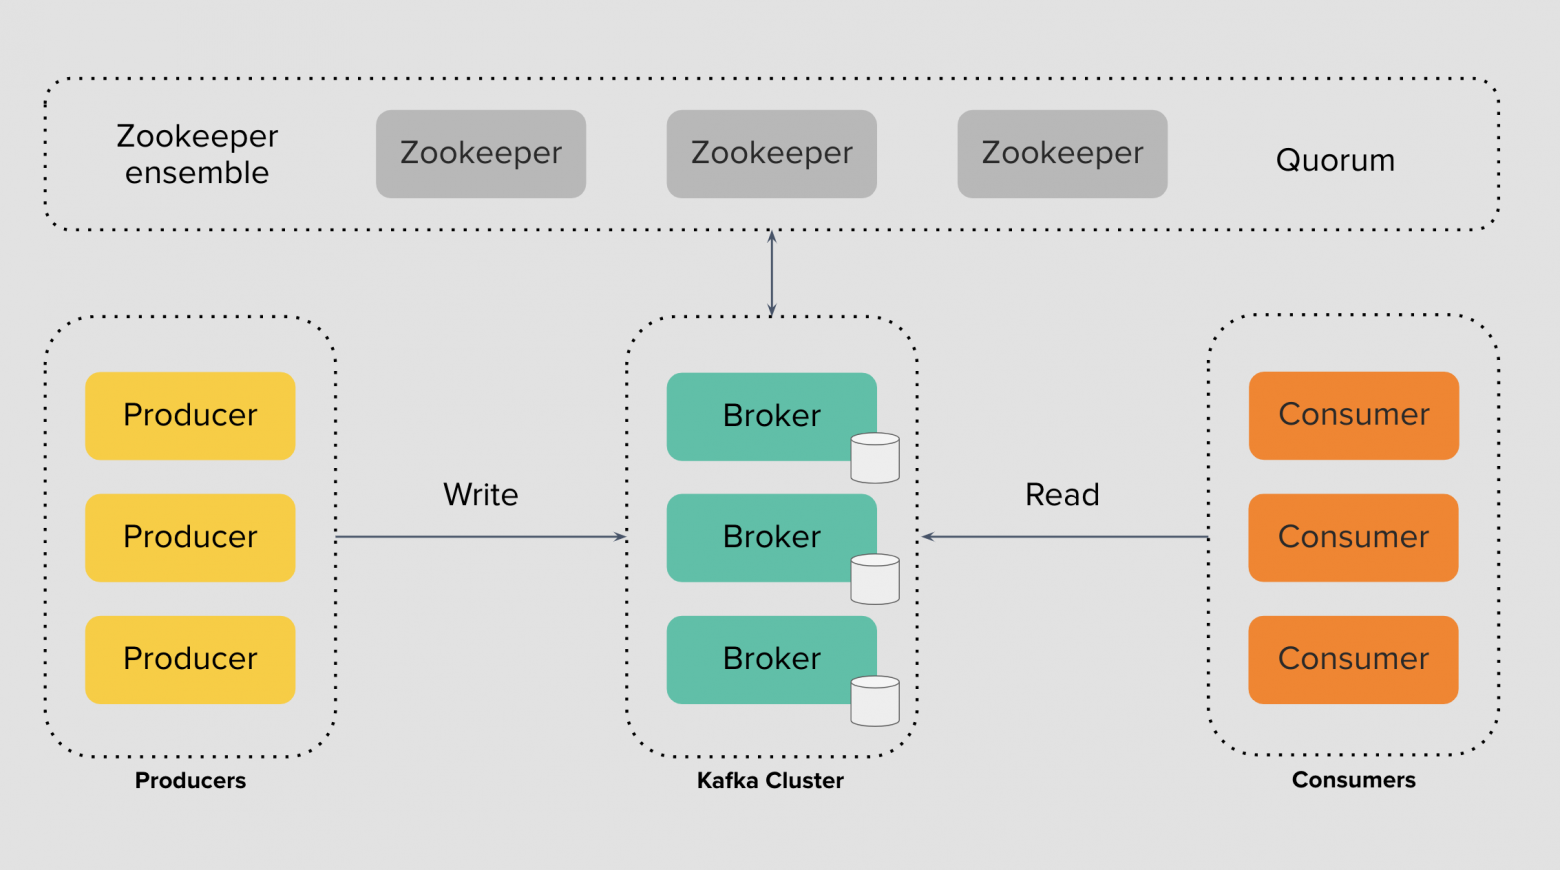
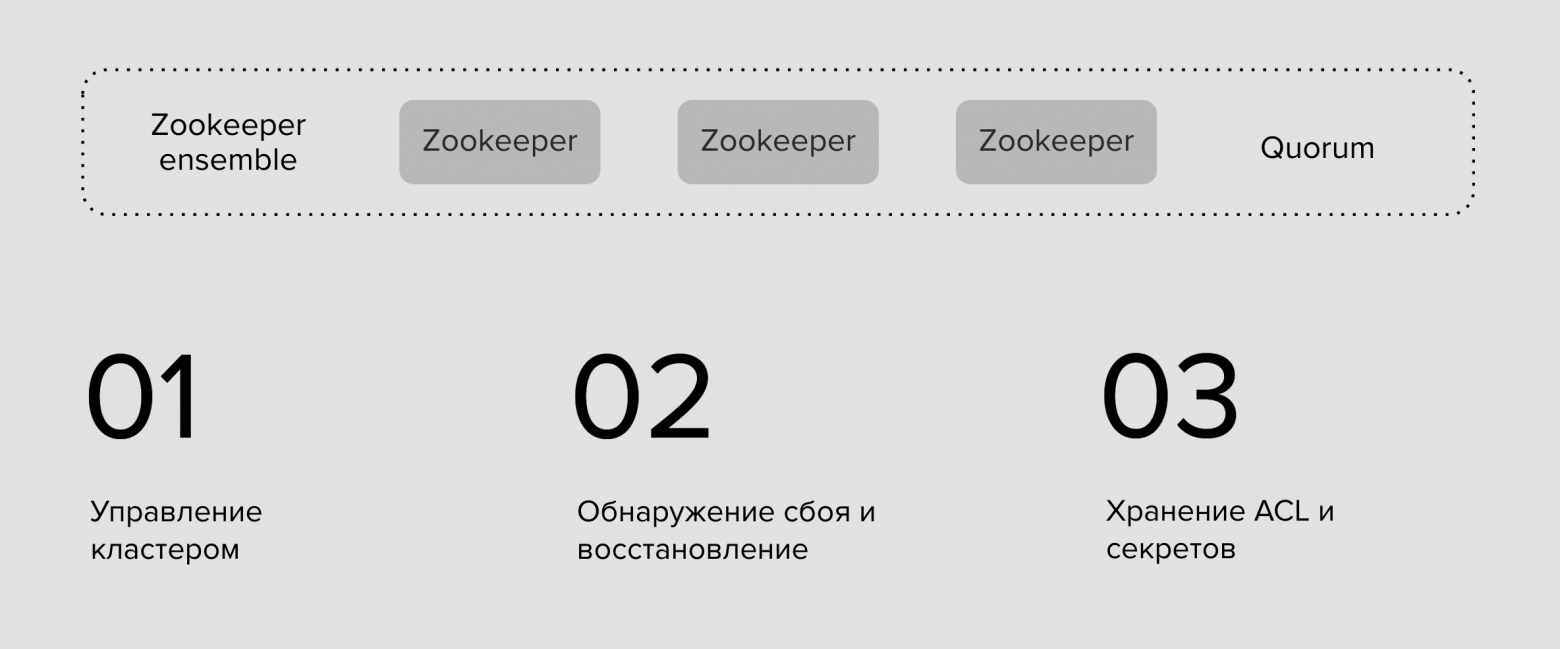
Начиная с Kafka 3.3–3.4 появился KRaft — собственный протокол консенсуса на основе Raft, который переносит метаданные внутрь самой Kafka. В Kafka 4.x ZooKeeper удалён полностью. Что это даёт: одна система вместо двух, быстрее failover контроллера, выше потолок по числу партиций в кластере. Сегодня новые кластеры поднимают только в KRaft-режиме — если видите в туториале zookeeper.connect, туториал устарел.
Часть II. Как устроено хранилище
5. Топик
Топик — это логическая категория событий одного типа. Статусы заказов, координаты курьеров, просмотры товаров — три разных топика.
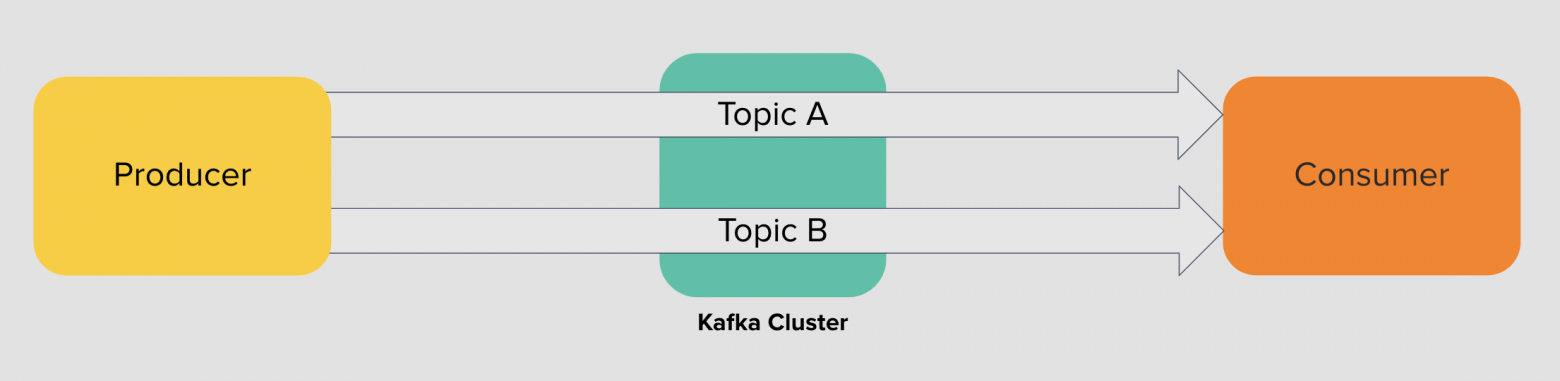
Ключевое слово — логическая. Не смешивайте в одном топике события разной природы: у них разные потребители, разный объём, разные требования к retention и разные схемы.
Связи «многие ко многим»: один продюсер может писать в несколько топиков, один консумер — читать несколько топиков, в один топик могут писать несколько продюсеров, и из одного топика могут читать сколько угодно независимых потребителей.
Имена: стандарта нет, но устойчивая практика — <домен>.<сущность>.<событие> в прошедшем времени: orders.order.created, payments.payment.captured. Прошедшее время подчёркивает, что это факт, а не команда.
6. Партиции
Один брокер упирается в свой потолок по CPU, диску и сети. Поэтому топик делится на части — партиции, и они раскладываются по разным брокерам.

Формально партиция и есть тот самый строго упорядоченный лог. Топик в целом порядка не имеет — порядок существует только внутри партиции. Это правило номер один в Kafka, и из него вытекает почти всё остальное.
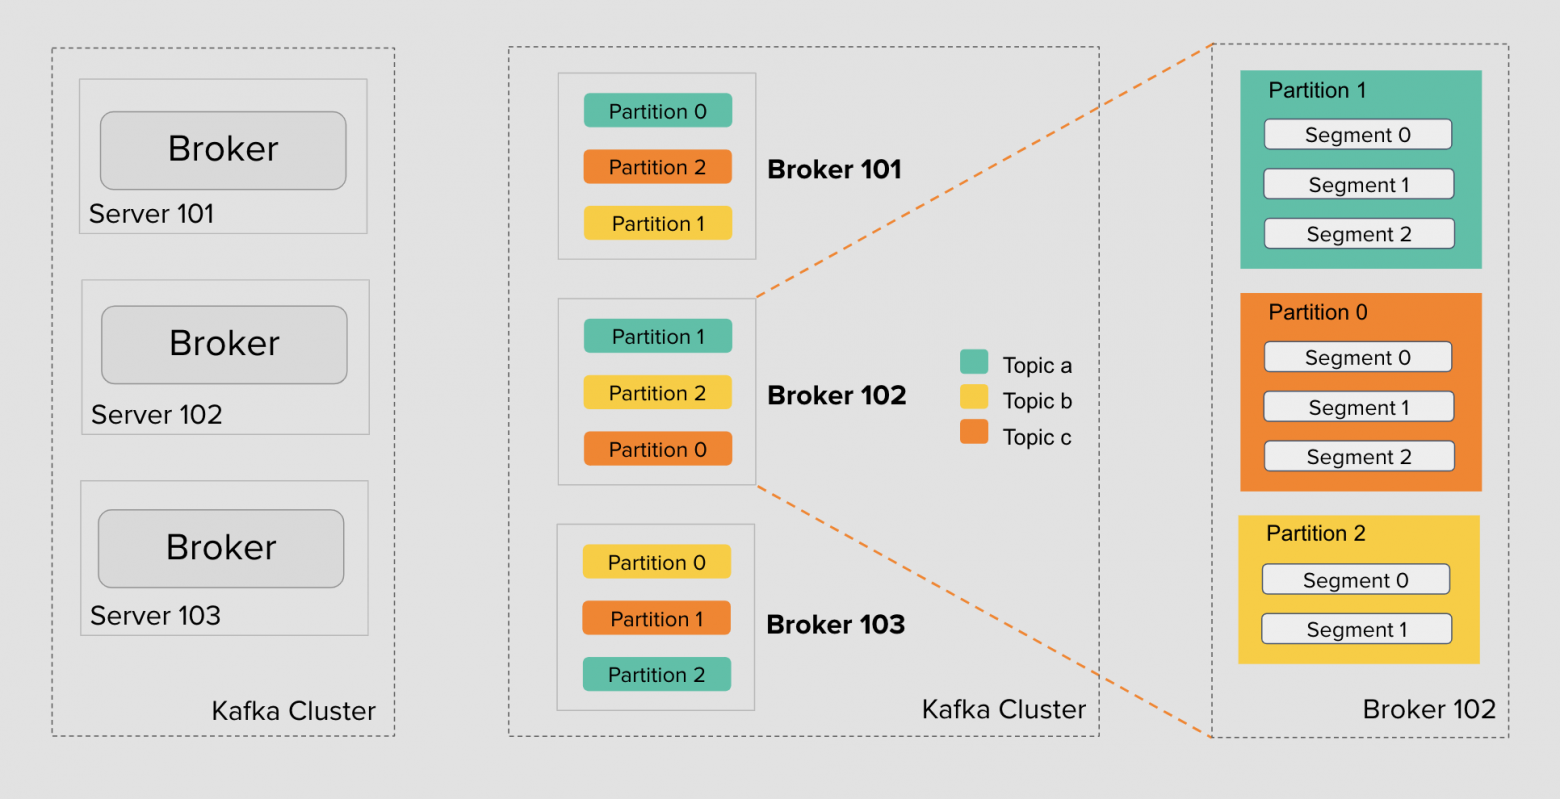
На картинке три брокера (101, 102, 103) и три топика, у каждого по три партиции; кластер распределил их автоматически при создании топика. Обратите внимание: Kafka не следит за тем, чтобы партиции оставались равномерно распределены со временем, и не перемещает их сама. Для этого есть отдельные инструменты (Cruise Control, встроенный kafka-reassign-partitions, коммерческие платформы).
Что даёт увеличение числа партиций:
- Параллелизм записи — продюсеры пишут в разные партиции на разных брокерах одновременно.
- Параллелизм чтения — число активных консумеров в одной группе не может превышать число партиций.
- Масштабирование по объёму — партиция должна помещаться на диск одного брокера, а топик — нет.
Чем платим: дольше ребаланс, больше открытых файлов и памяти на брокере, дольше failover при потере брокера, больше сетевых соединений. Число партиций можно увеличить, но не уменьшить, и при увеличении хеш-распределение ключей меняется — порядок для существующих ключей временно нарушается, а уже записанные сообщения никуда не переезжают.
7. Сегменты: как это лежит на диске
Партиция физически — это каталог с набором файлов, сегментов. Запись всегда идёт в активный сегмент; когда он достигает предела по размеру или возрасту, он закрывается и открывается новый.
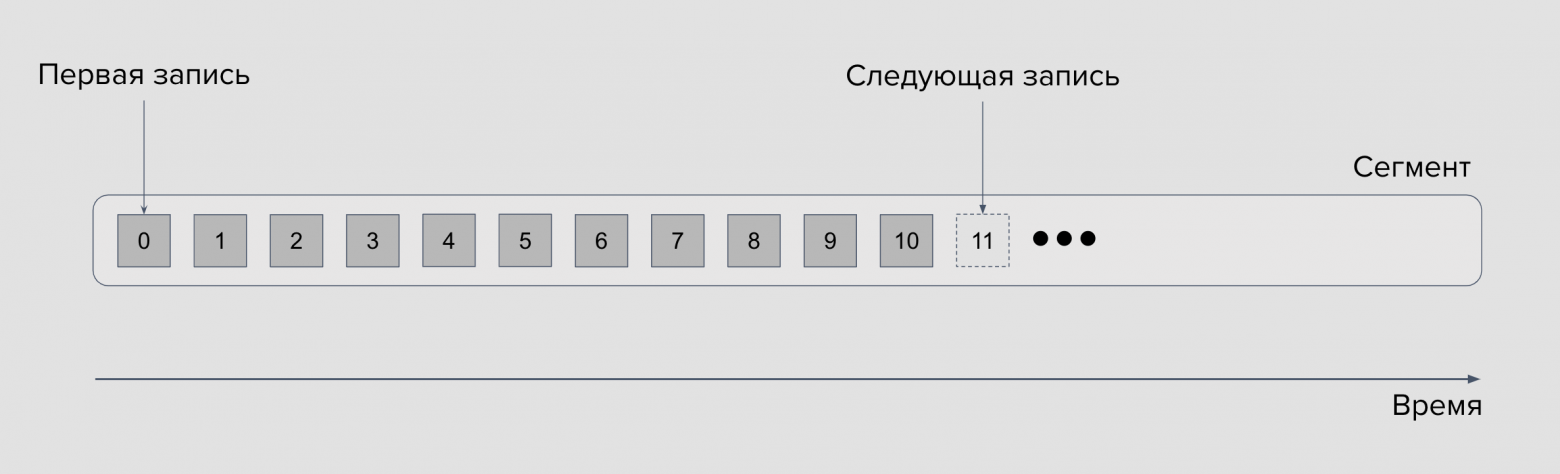
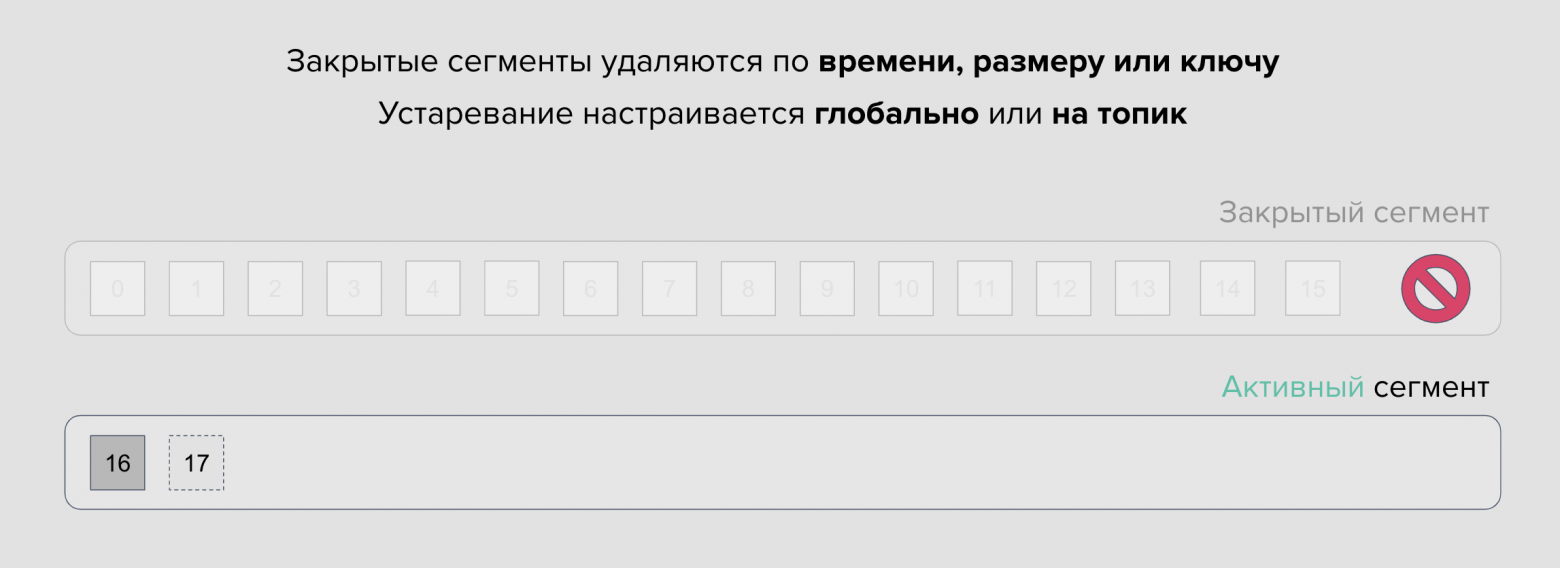
Почему это важно знать прикладному разработчику: Kafka удаляет не сообщения, а закрытые сегменты целиком. Настройка retention.ms=7d не означает, что ровно через семь дней сообщение исчезнет — оно исчезнет, когда сегмент, в котором оно лежит, будет закрыт и его возраст превысит retention. При редкой записи данные могут жить заметно дольше заявленного.
Настройки: segment.bytes (по умолчанию 1 ГБ), segment.ms. Пишете много крупных сообщений — увеличивайте сегмент; пишете редко и мелко — уменьшайте, иначе ротация будет происходить раз в вечность.
8. Оффсеты и лаг
Каждое сообщение в партиции получает оффсет — монотонно растущий порядковый номер. Счётчик свой у каждой партиции и с другими не пересекается.

Три позиции, которые надо различать:

- log-start offset — начало доступных данных (растёт по мере удаления старых сегментов);
- log-end offset — позиция последнего записанного сообщения;
- current offset — где сейчас находится консумер;
- лаг = log-end − current — сколько сообщений консумер ещё не обработал.
Лаг — метрика №1 для любого приложения на Kafka. Растущий лаг означает, что вы не успеваете: либо мало консумеров, либо обработка медленная, либо консумер упал. Допустимое значение зависит от бизнес-требований: для аналитики лаг в миллион сообщений нормален, для платежей — авария.
9. Структура сообщения
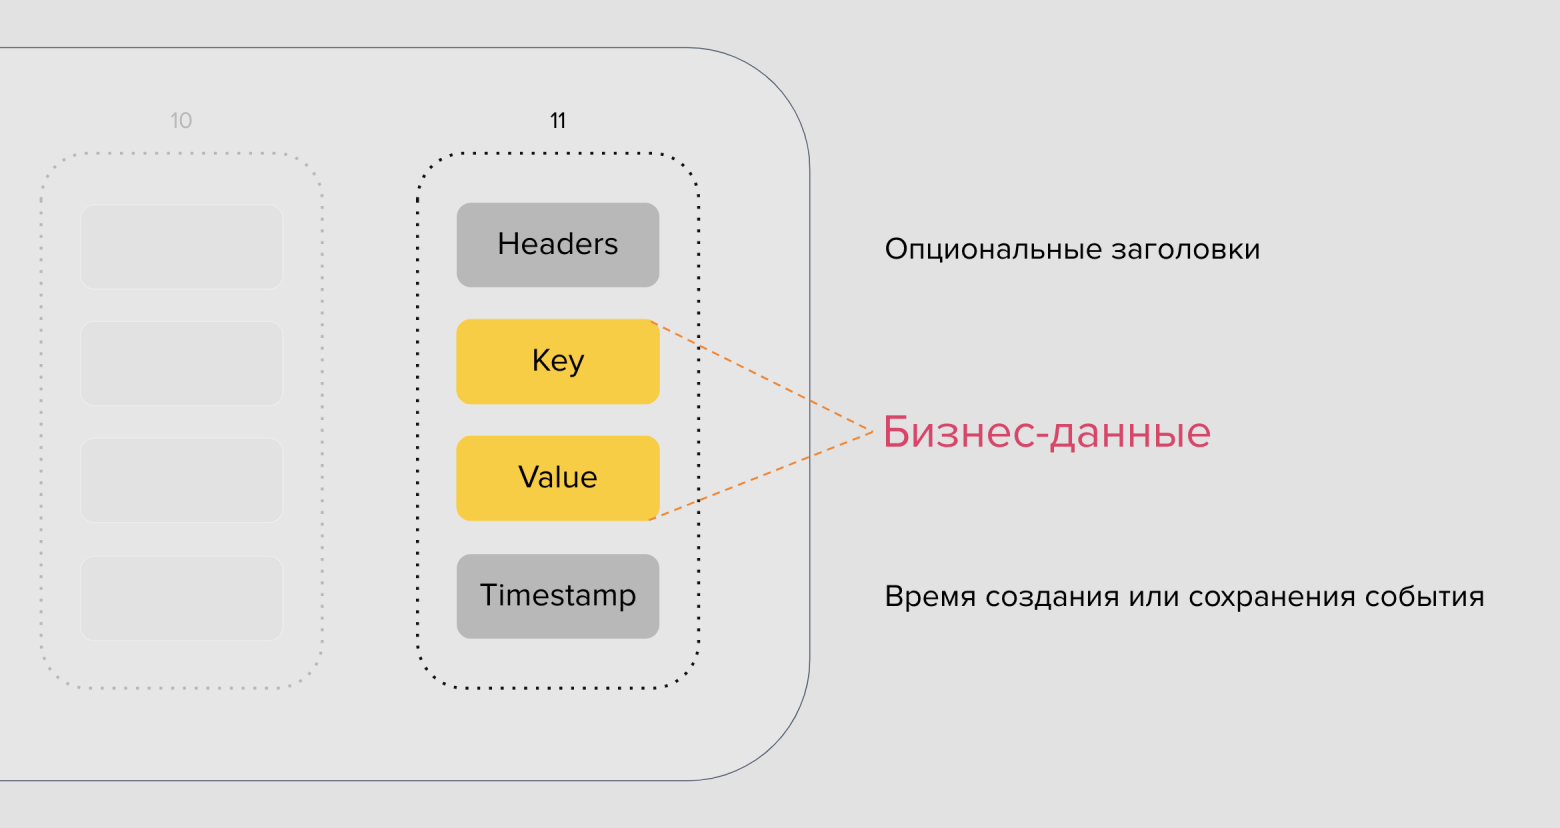
Сообщение (record) состоит из:
- Ключ — используется для выбора партиции. Может быть любым: число, строка, объект,
null. - Значение (payload) — собственно данные, сериализованные во что угодно: JSON, Protobuf, Avro.
- Timestamp — проставляет продюсер либо брокер в момент приёма (
message.timestamp.type). - Заголовки (headers) — строковые пары ключ-значение, как в HTTP. Появились в 0.11.
Заголовки — недооценённая вещь. В них кладут метаданные, которые нужны инфраструктуре, а не бизнес-логике: traceparent для сквозной трассировки (W3C Trace Context), event_type и schema_version для маршрутизации и фильтрации без десериализации payload, идентификатор продюсера, MIME-type, подпись. Сами данные в заголовки класть не надо.
Практика: на уровне приложения удобно завести общий envelope для всех событий:
message Envelope {
  string event_id           = 1;  // UUID v7 — для дедупликации на стороне консумера
  string event_type         = 2;  // "orders.order.created"
  string aggregate_id       = 3;  // совпадает с ключом сообщения
  int64  occurred_at_unix_ms = 4;
  int32  schema_version     = 5;
  google.protobuf.Any payload = 6;
}
10. Retention и compaction
Две политики очистки (cleanup.policy):
| Политика | Что делает | Когда |
|---|---|---|
delete (по умолчанию) | удаляет закрытые сегменты старше retention.ms или сверх retention.bytes | поток событий: клики, заказы, метрики |
compact | оставляет последнее значение для каждого ключа, старые версии убирает | «текущее состояние сущности»: профиль пользователя, конфигурация, справочник |
delete,compact | обе сразу | компактить, но и не хранить вечно |
Compacted-топик — это фактически распределённый key-value снапшот: новый инстанс сервиса читает топик с начала и восстанавливает актуальное состояние. На нём же работают внутренние механизмы Kafka (__consumer_offsets). Нюанс: сообщение с null в значении — это tombstone, маркер удаления ключа.
Хранить события можно и вечно (retention.ms=-1) — ограничение только в объёме дисков.
11. Репликация
Если партиция существует в одном экземпляре, падение брокера означает недоступность части данных. Поэтому у партиции есть реплики, число задаётся replication.factor.

Одна реплика — лидер, остальные — фолловеры. Продюсер пишет в лидера; фолловеры сами подключаются к лидеру, вычитывают данные и асинхронно сохраняют к себе.

Консумеры традиционно тоже читают с лидера — это даёт консистентность. С версии 2.4 возможно чтение с ближайшего фолловера (rack awareness): меньше задержка и трафик между зонами доступности, но из-за асинхронной репликации данные чуть менее свежие.

Роли не статичны: при падении брокера лидерство переходит к одной из реплик, а клиенты по протоколу узнают новую топологию и переподключаются. Поэтому клиентская библиотека всегда получает список брокеров лишь как «точку входа» (bootstrap.servers), а дальше сама выясняет, кто лидер какой партиции.
ISR (in-sync replicas) — подмножество реплик, догнавших лидера в пределах replica.lag.time.max.ms. Отставшая реплика выпадает из ISR и не учитывается при подтверждении записи. Отсюда связка: replication.factor=3 + min.insync.replicas=2 + acks=all = запись подтверждается, только когда её приняли минимум две реплики, и переживает падение одного брокера.
Ещё одна настройка, про которую забывают: unclean.leader.election.enable=false. Она запрещает выбирать лидером реплику, которая не была в ISR. Иначе при неудачном стечении обстоятельств кластер молча потеряет данные ради доступности.
12. Почему Kafka быстрая
Вопрос с собеседований, ответ из четырёх пунктов:
- Последовательный I/O. Append-only лог — это линейная запись, которая на порядок быстрее случайной даже на SSD.
- Page cache вместо собственного кэша. Kafka не держит данные в куче JVM, а полагается на страничный кэш ОС. Свежезаписанное сообщение почти наверняка ещё в памяти, когда его читает консумер.
- Zero-copy. Отдача данных консумеру идёт через
sendfile(): байты уходят из page cache в сокет, минуя user space. - Батчинг и сжатие. И продюсер, и консумер работают пачками; сжатие (
snappy,lz4,zstd) применяется к батчу целиком, а брокер хранит и отдаёт его в сжатом виде, не распаковывая.
Плюс сам протокол бинарный и простой, а брокер не ведёт учёт состояния каждого сообщения — только позиции групп.
Часть III. Продюсер
13. Партицирование: как выбирается партиция
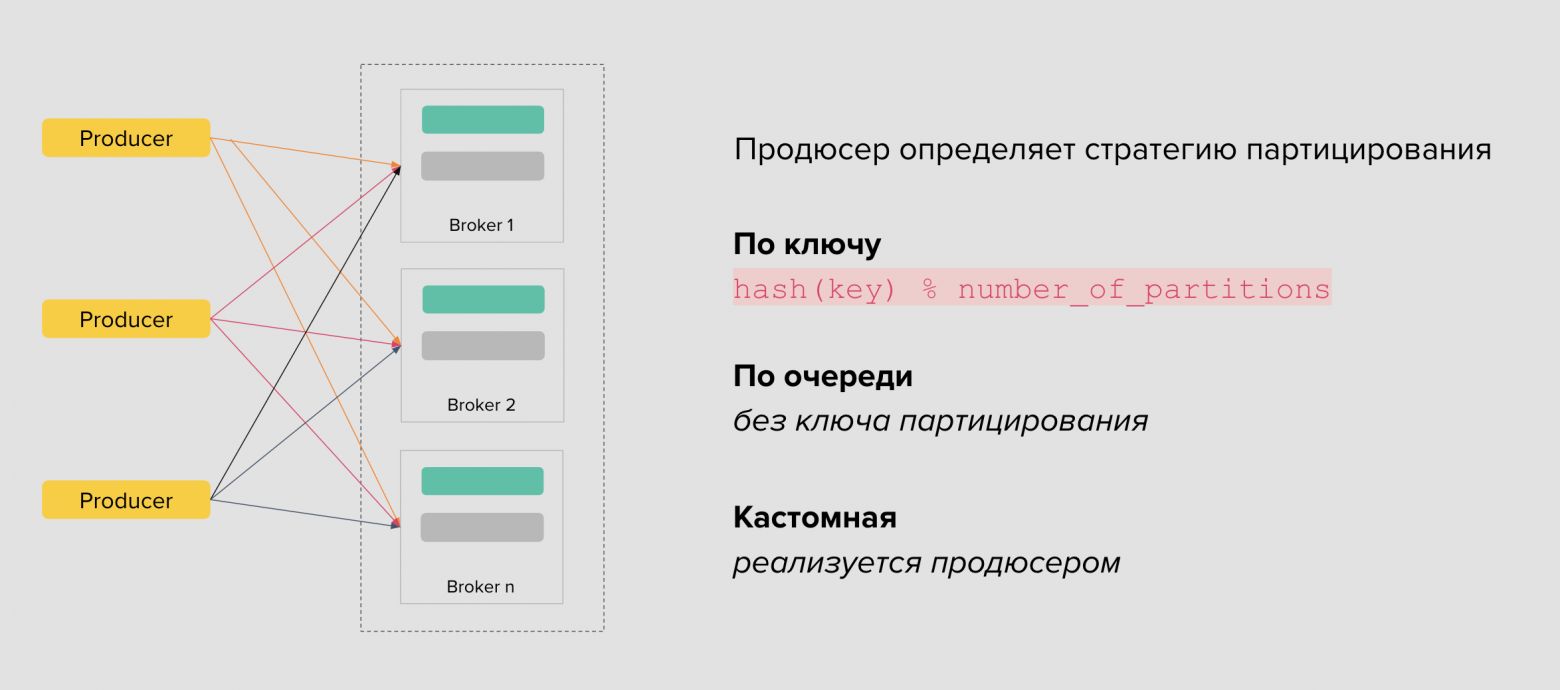
Решение принимает продюсер, а не брокер. Стандартные стратегии:
- Есть ключ → hash-based.
murmur2(key) % partitions. Одинаковый ключ всегда попадает в одну партицию → строгий порядок событий для этой сущности. - Нет ключа → round-robin / sticky. Сообщения раскладываются равномерно, порядка между ними нет. Sticky-вариант (с 2.4) держится одной партиции, пока батч не заполнится — это лучше для пропускной способности.
- Кастомная стратегия (list-based, range-based, composite) — если нужна своя логика.
Как выбирать ключ. Ключ = идентификатор сущности, для которой важен порядок, при условии равномерного распределения.
| Домен | Плохой ключ | Что ломается | Хороший ключ |
|---|---|---|---|
| Заказы | без ключа | paid может обогнать created | order_id |
| Действия пользователей | country | три страны → три горячие партиции | user_id |
| Телеметрия устройств | device_type | 90% устройств одного типа | device_id |
| Операции по счёту | transaction_id | операции счёта разъезжаются, баланс «прыгает» | account_id |
Hot partition — самая частая продовая проблема: один ключ (крупный клиент, популярный товар, автор-«миллионник») даёт непропорционально много событий, одна партиция и один консумер перегружены, остальные простаивают. Лечение: составной ключ user_id:bucket, если порядок внутри можно ослабить, либо вынос «тяжёлых» ключей в отдельный топик.
14. Дизайн продюсера
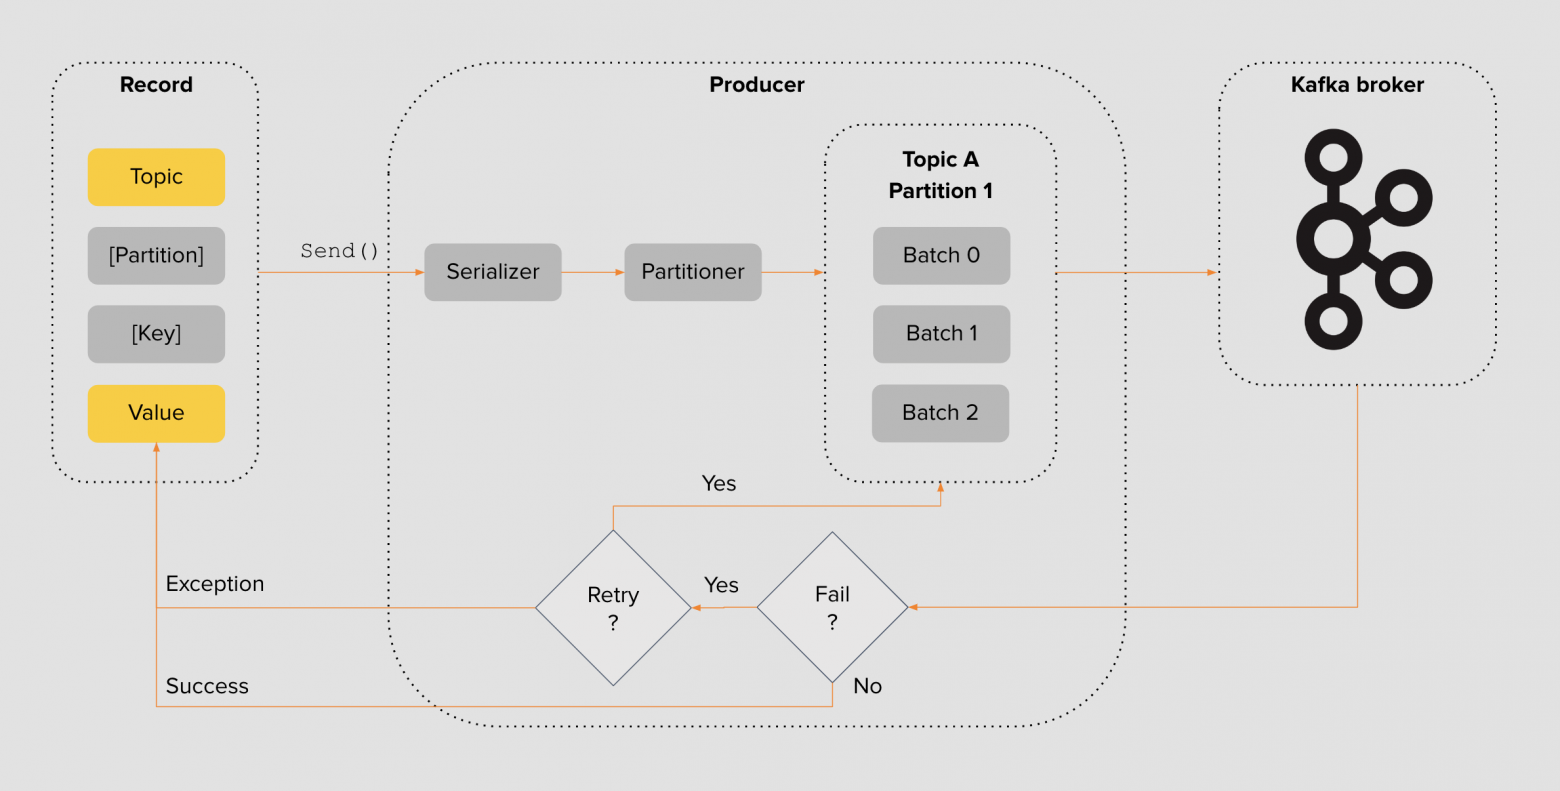
Что происходит внутри клиентской библиотеки на каждом Produce:
- Payload упаковывается в структуру с топиком, опциональной партицией и ключом.
- Сериализуется (JSON / Protobuf / Avro).
- Выбирается партиция по ключу и стратегии.
- Сообщение кладётся в аккумулятор — буфер батчей по партициям.
- Батч уходит брокеру, когда набрался
batch.sizeили истёкlinger.ms. - Продюсер ждёт подтверждения согласно
acks; при ошибке — ретраит.
Основные ручки:
| Параметр | Смысл | Разменивает |
|---|---|---|
batch.size | максимальный размер батча | память ↔ пропускная способность |
linger.ms | сколько ждать, добивая батч | задержка ↔ пропускная способность |
compression.type | none/snappy/lz4/zstd | CPU ↔ сеть и диск |
acks | уровень подтверждения | задержка ↔ надёжность |
max.in.flight.requests.per.connection | сколько неподтверждённых запросов в полёте | пропускная способность ↔ порядок (с идемпотентностью ≤5 порядок сохраняется) |
retries / delivery.timeout.ms | сколько и как долго пытаться | доступность ↔ latency |
buffer.memory | размер аккумулятора; при переполнении send блокируется | backpressure |
linger.ms=0 (дефолт) — минимальная задержка, много мелких запросов. Поставить linger.ms=5 почти всегда выгодно: задержка вырастает на миллисекунды, а пропускная способность — в разы.
15. Семантики доставки
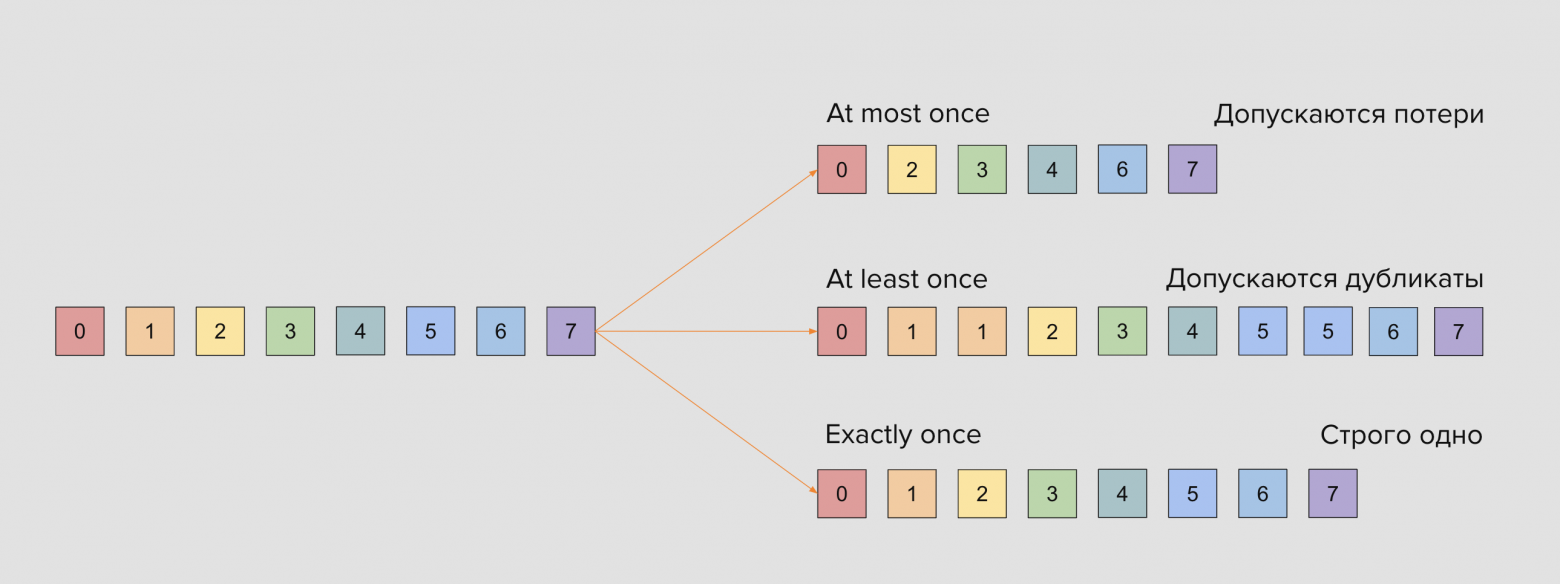
- at-most once — допускаем потери, но не дубликаты. Самая слабая гарантия и самая быстрая.
- at-least once — не теряем, но допускаем дубликаты. Рабочий дефолт для бизнес-логики.
- exactly-once — ни потерь, ни дублей. Дороже всех по задержке.
Соблазн выбрать exactly-once везде — ошибка. Для координат курьера потеря одной точки безразлична (at-most once достаточно), а для идемпотентной обработки дубль безвреден (at-least once). Надёжность стоит задержек, и платить за неё имеет смысл там, где это действительно нужно.
16. acks и min.insync.replicas

acks | Чего ждём | Риск |
|---|---|---|
0 / none | ничего, отправили и забыли | сообщение может потеряться незаметно |
1 / leader | лидер записал на свой диск | лидер упал до репликации → потеря |
-1 / all | записали лидер и все реплики из ISR | медленнее, зато переживает падение брокера |
Классическая ошибка конфигурации: выставить min.insync.replicas равным числу реплик. Тогда при потере одного брокера продюсер вообще перестанет писать — он не дождётся подтверждения нужного количества реплик. Правильно: min.insync.replicas на единицу меньше replication.factor (3 и 2 — стандартная пара).
17. Идемпотентный продюсер и транзакции
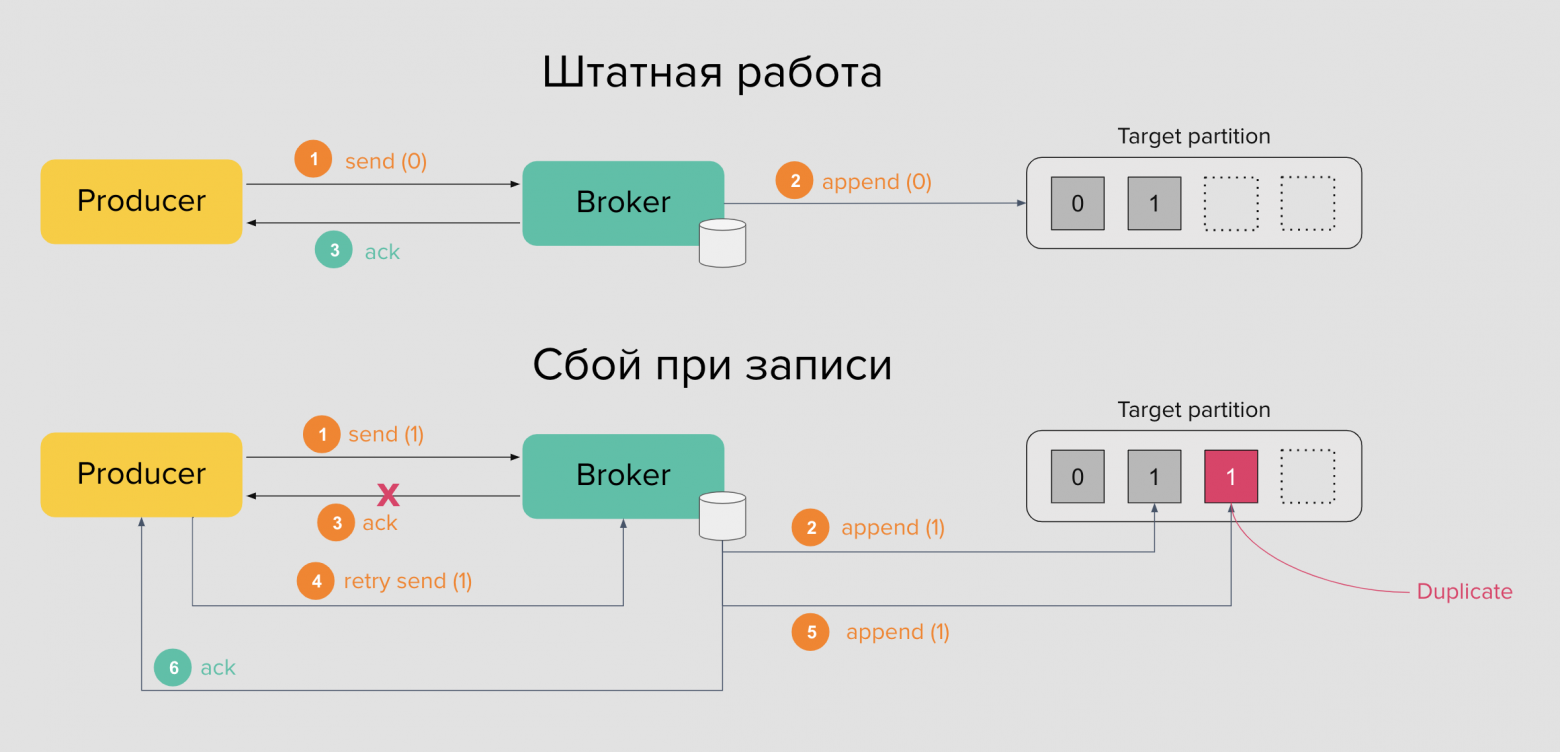
Даже с acks=all дубликаты возможны. Сценарий: брокер сохранил сообщение, но подтверждение не дошло до продюсера из-за сетевой проблемы. Продюсер добросовестно повторяет отправку — в логе появляется второе такое же сообщение.
Решение — enable.idempotence=true: каждому продюсеру выдаётся PID, а каждому сообщению — монотонный sequence number в рамках партиции. Брокер отбрасывает повтор с уже виденным номером. В современных клиентах идемпотентность включена по умолчанию; накладных расходов практически нет. Правило: если acks=all, то идемпотентность включена — иначе вы просто не используете то, за что уже платите задержкой.
Транзакции (transactional.id) идут дальше: позволяют атомарно записать в несколько партиций и топиков и закоммитить оффсет консумера в той же транзакции. Это и есть настоящий exactly-once, но только внутри Kafka — для паттерна read-process-write (Kafka Streams). Потребитель должен читать с isolation.level=read_committed, иначе увидит незакоммиченные сообщения.
18. Dual write: чего Kafka не решает
Ни один параметр продюсера не спасает от проблемы записи в два хранилища. Приложение делает INSERT в PostgreSQL и Produce в Kafka — общей транзакции между ними нет:
- «сначала БД, потом Kafka» → упали между → данные есть, события нет;
- «сначала Kafka, потом БД» → упали между → событие о несуществующей сущности.
Решение — transactional outbox: событие пишется в таблицу outbox в той же транзакции, что и бизнес-данные, а отдельный процесс (polling relay или CDC через Debezium) публикует его в Kafka.
CREATE TABLE outbox (
  id           uuid PRIMARY KEY,     -- UUID v7: сортируется по времени
  aggregate_id text NOT NULL,        -- = ключ сообщения
  topic        text NOT NULL,
  headers      jsonb NOT NULL DEFAULT '{}',
  payload      bytea NOT NULL,
  created_at   timestamptz NOT NULL DEFAULT now(),
  published_at timestamptz
);
CREATE INDEX outbox_pending ON outbox (id) WHERE published_at IS NULL;
Relay может упасть между Produce и UPDATE published_at → в Kafka уедет дубль → консумер обязан быть идемпотентным (§22). Связка outbox + идемпотентный консумер и даёт «ни потерь, ни двойных эффектов» при at-least-once на каждом отдельном шаге.
Подробное описание паттерна: microservices.io — Transactional outbox.
Часть IV. Консумер
19. Дизайн консумера

Цикл типичного консумера:
poll()— забрать пачку записей из назначенных партиций (блокируется доmax.poll.recordsили таймаута).- Десериализовать.
- Обработать.
- Закоммитить оффсет.
Каждый шаг настраивается, и именно от момента коммита зависит семантика:
| Когда коммитим | Семантика | Что при падении |
|---|---|---|
| до обработки | at-most once | обработка не завершилась → сообщение потеряно |
| после обработки | at-least once | упали между обработкой и коммитом → повтор |
авто-коммит раз в auto.commit.interval.ms | непредсказуемо | выключать для бизнес-логики (enable.auto.commit=false) |
Коммит бывает синхронный (надёжнее, медленнее) и асинхронный (быстрее, может потеряться — обычно комбинируют: async в цикле, sync при завершении).
Exactly-once для связки Kafka → внешняя БД не существует. Максимум, что достижимо, — at-least-once + идемпотентность = effectively-once. Это честный ответ на собеседовании.
20. Консумер-группы
Один консумер на весь топик — это не масштабируется. Консумеры объединяются в группу с общим group.id.

Правила:
- Партиция читается ровно одним консумером внутри группы.
- Один консумер может читать несколько партиций и несколько топиков.
- Каждая группа читает топик независимо и держит свои оффсеты. Так Kafka совмещает две модели: внутри группы — очередь с балансировкой, между группами — publish/subscribe.
- Имена групп глобальны в пределах кластера.
Главное преимущество группы перед «просто консумером»: оффсеты хранятся на стороне брокера (во внутреннем compacted-топике __consumer_offsets). Приложение можно деплоить, перезапускать и масштабировать — чтение продолжится с сохранённой позиции, и не нужно самому городить хранилище позиций.
auto.offset.reset определяет, откуда начинать новой группе: earliest (вся история) или latest (только новое). Топик мог существовать год, а сервис появился вчера — выбор зависит от бизнес-логики. Для аналитики и восстановления read-моделей обычно earliest, для нотификаций — latest.
21. Ребалансировка
Любое изменение состава группы или числа партиций запускает ребалансировку — переназначение партиций между участниками.
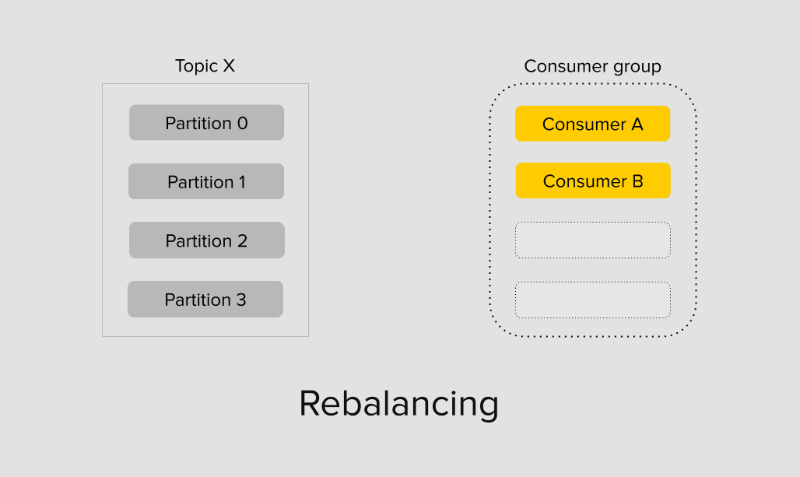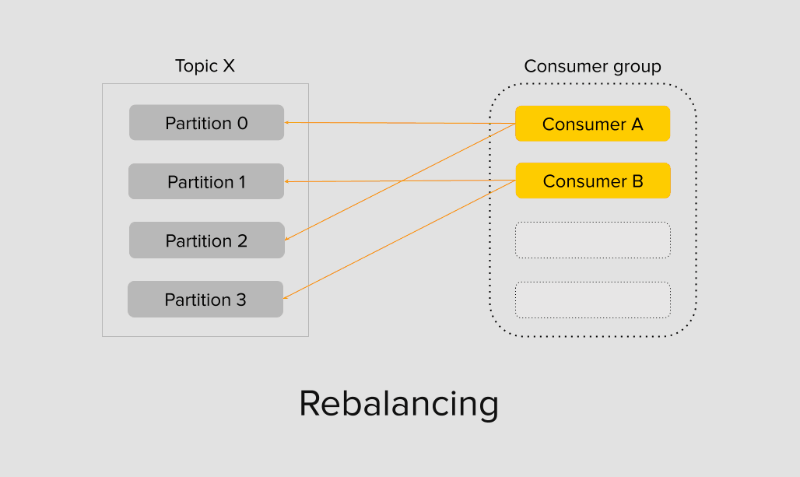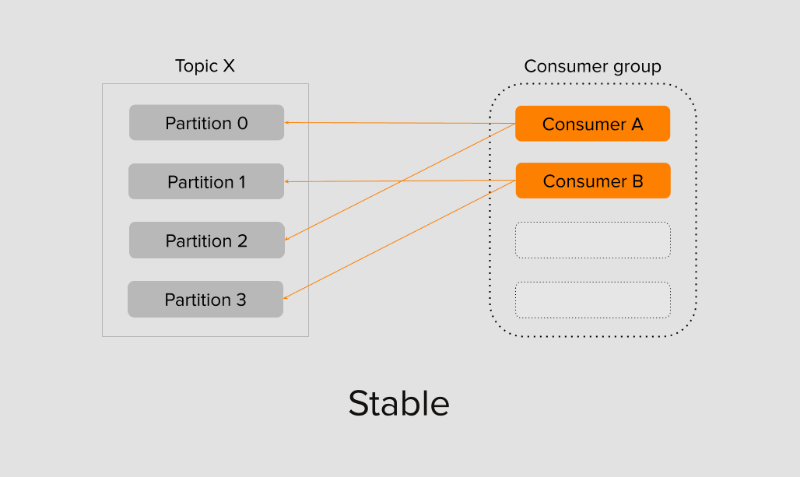
Как это работает:
- На брокере есть Group Coordinator — процесс, отвечающий за группу.
- Консумеры шлют
JoinGroup; первый вошедший становится Group Leader. - Лидер группы вычисляет распределение партиций по выбранной стратегии и рассылает его через координатора.
- Пока группа не стабилизировалась, чтение не идёт.

Живость участников контролируется двумя таймерами:
heartbeat.interval.ms— как часто консумер шлёт heartbeat;session.timeout.ms— если за это время не пришло ни одного heartbeat, координатор выкидывает консумера и запускает ребаланс.
Практическое правило: heartbeat-интервал в 3–4 раза меньше session timeout. Слишком большие значения — долго обнаруживаем «выпавшего»; слишком маленькие — группа уходит в ребаланс от любого сетевого чиха.
Третий таймер отдельный и самый коварный: max.poll.interval.ms (по умолчанию 5 минут). Если обработка батча заняла дольше, брокер считает консумера мёртвым — начинается ребаланс, консумер возвращается, снова ребаланс. Это rebalance storm, классика при тяжёлой обработке. Лечение: уменьшить max.poll.records, выносить долгую работу в отдельные горутины/пул, не блокировать poll-цикл.
Стратегии назначения:
| Стратегия | Поведение |
|---|---|
range | партиции топика режутся диапазонами по консумерам; при нескольких топиках перекашивает нагрузку |
roundrobin | все партиции всех топиков раскладываются по кругу |
sticky | старается сохранить прежнее назначение, минимизируя переезды |
cooperative-sticky | инкрементальный ребаланс: забирает только те партиции, которые реально переезжают, остальные продолжают читаться без остановки |
По умолчанию (в старых клиентах) ребаланс — Stop-The-World для всей группы. cooperative-sticky сильно смягчает боль и сегодня является рекомендуемым выбором. Дополнительно: static membership (group.instance.id) — консумер при перезапуске сохраняет свои партиции и ребаланс не запускается вовсе, что идеально для rolling update в Kubernetes. В новых версиях протокола (KIP-848) координация переносится на брокера и stop-the-world уходит окончательно.
Больше консумеров, чем партиций — бесполезно.

Лишние участники группы просто простаивают: одну партицию не могут читать двое. Отсюда правило — закладывайте достаточное число партиций заранее. Добавить партиции потом можно, но это ломает порядок по ключам и не перераспределяет уже записанные сообщения.
Ещё одна рекомендация из практики: держать по одной консумер-группе на топик (или на небольшой набор связанных топиков). Огромная группа на десяток топиков превращает каждый ребаланс в событие масштаба инцидента.
22. Идемпотентный консумер
At-least-once гарантирует дубли, значит обработчик обязан их переживать. Канонический способ — таблица обработанных событий, обновляемая в той же транзакции, что и бизнес-эффект:
CREATE TABLE processed_events (
  event_id     uuid PRIMARY KEY,
  processed_at timestamptz NOT NULL DEFAULT now()
);
BEGIN;
INSERT INTO processed_events (event_id) VALUES ($1) ON CONFLICT DO NOTHING;
-- если RowsAffected = 0 → это дубль, откатываем и выходим
UPDATE ...; -- бизнес-эффект
INSERT INTO outbox ...; -- следующее событие, если нужно
COMMIT;
Три вещи в одной транзакции: отметка о событии, изменение данных, исходящее событие. Упало что угодно — откатилось всё, событие придёт снова, начнём с чистого листа.
Альтернативы, когда БД нет под рукой: дедупликация в Redis по event_id с TTL (слабее — Redis может вытеснить ключ), или естественная идемпотентность операции (SET status='paid' идемпотентен сам по себе, в отличие от balance = balance - 100).
23. Паттерны обработки
| Паттерн | Суть |
|---|---|
| Retry с backoff + jitter | 2–3 попытки на месте для временных ошибок (БД недоступна, таймаут) |
| Retry topic | <topic>.retry с заголовком retry_at; отдельный консумер ждёт и возвращает в основной. Не блокирует партицию, но ломает порядок для ключа |
| Dead Letter Queue | <topic>.dlq для «ядовитых» сообщений с заголовками error, original_topic/partition/offset; алерт на рост, утилита для reprocess |
| Классификация ошибок | permanent (битый payload, неизвестный тип) → сразу DLQ; retryable → backoff |
| Батч-обработка | обработать пачку в одной транзакции БД (bulk insert), коммитить оффсет после батча |
| Параллелизм по партициям | горутина на партицию, записи внутри партиции строго последовательно — порядок сохраняется |
| Pause / Resume | при backpressure приостановить партицию, а не перестать звать poll (иначе вылет из группы) |
Важное следствие последней строки: нельзя просто «не поллить», когда не успеваете — вы вылетите из группы по max.poll.interval.ms. Правильный backpressure — pause на партиции с продолжением poll-цикла.
Часть V. Kafka в архитектуре
24. Схемы и эволюция контрактов
Топик — это публичный API вашего сервиса, и он живёт дольше, чем код. Формат значения:
| Формат | Плюсы | Минусы |
|---|---|---|
| JSON | читаемо, ничего не нужно | нет схемы, объёмно, легко сломать потребителей |
| Avro | компактно, схема встроена в экосистему Confluent | нужен Schema Registry |
| Protobuf | типизация, генерация кода, строгие правила совместимости | нужен тулинг (buf) |
Правила эволюции, одинаковые по сути везде: добавлять поля можно; удалять, переименовывать и менять тип — нельзя; номера полей не переиспользовать (в protobuf — reserved). Новый потребитель должен уметь читать старые сообщения, старый — не падать на новых.
Schema Registry (Confluent, Apicurio) нужен, когда продюсеров много, они на разных языках и в разных командах: продюсер регистрирует схему, реестр отклоняет несовместимую. В монорепе на одном языке ту же роль выполняет buf breaking в CI.
25. Kafka vs альтернативы
| Kafka | RabbitMQ | NATS JetStream | SQS/SNS | Redis Streams | |
|---|---|---|---|---|---|
| Модель | лог, pull | очередь, push, ack на сообщение | лог + очередь | очередь / fan-out | лог |
| Replay истории | да | нет | да | нет | да |
| Независимые читатели | группы | exchange → N очередей (копии) | да | SNS → N SQS | группы |
| Порядок | по ключу в партиции | по очереди, ломается при nack | по subject | FIFO-очереди с ограничениями | по стриму |
| Роутинг | топик | богатый (exchange, routing key, headers) | subject wildcards | фильтры SNS | нет |
| Пропускная способность | миллионы/с | десятки тысяч/с | сотни тысяч/с | managed | сотни тысяч/с |
| Retention | дни–недели, терабайты | до ack | настраиваемо | до 14 дней | по длине |
| Delayed / priority | нет из коробки | да | нет | delay есть | нет |
| Эксплуатация | тяжёлая | средняя | лёгкая | нулевая | лёгкая |
| Экосистема | Connect, Streams, Debezium, ClickHouse, Flink | плагины | небольшая | AWS | нет |
RabbitMQ лучше, когда: нужна сложная маршрутизация, приоритеты, per-message TTL, delayed messages из коробки, задачи «выполни и подтверди» с небольшим объёмом, маленькая команда без Kafka-экспертизы.
Kafka лучше, когда: одно событие нужно многим потребителям; нужен replay и аудит; высокая пропускная способность; порядок по ключу; интеграция с аналитикой (CDC, ClickHouse, Flink, Spark).
NATS / Redis Streams: внутренняя лёгкая очередь одного сервиса или low-latency messaging, где Kafka избыточна.
26. Классические use case’ы
- Интеграция микросервисов через события. Сервис публикует доменные события, остальные подписываются. Основа хореографической саги и CQRS read-моделей.
- Change Data Capture. Debezium читает WAL PostgreSQL или binlog MySQL и публикует изменения строк. Так строят реплики в Elasticsearch, ClickHouse, кэши и DWH, не трогая код приложения.
- Clickstream и продуктовая аналитика. Изначальный сценарий LinkedIn: действия пользователей → топики → real-time и batch обработка.
- Логи и метрики. Приложения пишут в топик, потребители — ELK, ClickHouse, S3.
- Stream processing. Kafka Streams / Flink / ksqlDB: обогащение, join потоков, оконные агрегации (антифрод, real-time дашборды).
- Event sourcing. Состояние агрегата = свёртка событий; Kafka как хранилище (обычно с compaction). Как единственное хранилище спорно — чаще в паре с БД.
- Буфер между системами с разной скоростью. Пик 100k/с на входе, БД тянет 10k/с — Kafka сглаживает, консумеры разгребают.
- Compacted-топик как распределённый конфиг/справочник. Новый инстанс читает топик с начала и получает актуальное состояние.
Часть VI. Практика на Go (twmb/franz-go)
Почему franz-go: чистый Go без CGO (в отличие от confluent-kafka-go поверх librdkafka), полная поддержка протокола (транзакции, KRaft admin, новые протоколы групп), лучшая производительность среди Go-клиентов. segmentio/kafka-go проще по API, но медленнее и отстаёт по фичам. Репозиторий и примеры: https://github.com/twmb/franz-go
27. Продюсер
import (
    "github.com/twmb/franz-go/pkg/kgo"
    "github.com/twmb/franz-go/plugin/kotel"
)

func NewProducer(brokers []string, clientID string) (*kgo.Client, error) {
    tracer := kotel.NewTracer() // OpenTelemetry: span на produce + traceparent в headers
    return kgo.NewClient(
        kgo.SeedBrokers(brokers...),
        kgo.ClientID(clientID),
        kgo.RequiredAcks(kgo.AllISRAcks()),                    // acks=all
        // идемпотентность включена по умолчанию; отключается kgo.DisableIdempotentWrite()
        kgo.ProducerBatchCompression(kgo.SnappyCompression()),
        kgo.ProducerLinger(5*time.Millisecond),                // добить батч: throughput ↔ latency
        kgo.RecordRetries(10),
        kgo.RecordDeliveryTimeout(30*time.Second),
        kgo.WithHooks(kotel.NewKotel(kotel.WithTracer(tracer)).Hooks()...),
    )
}

// Синхронная публикация: возвращаемся только после ack брокера.
func Publish(ctx context.Context, cl *kgo.Client, topic, key string, value []byte, headers map[string]string) error {
    rec := &kgo.Record{Topic: topic, Key: []byte(key), Value: value}
    for k, v := range headers {
        rec.Headers = append(rec.Headers, kgo.RecordHeader{Key: k, Value: []byte(v)})
    }
    return cl.ProduceSync(ctx, rec).FirstErr()
}

// Асинхронная — для высокой пропускной способности.
func PublishAsync(ctx context.Context, cl *kgo.Client, rec *kgo.Record) {
    cl.Produce(ctx, rec, func(r *kgo.Record, err error) {
        if err != nil {
            produceErrors.WithLabelValues(r.Topic).Inc()
        }
    })
}
28. Outbox relay (polling publisher)
func (r *Relay) drainOnce(ctx context.Context) error {
    tx, err := r.pool.Begin(ctx)
    if err != nil {
        return err
    }
    defer tx.Rollback(ctx)

    // SKIP LOCKED: несколько инстансов relay работают параллельно, не мешая друг другу
    rows, err := tx.Query(ctx, `
        SELECT id, aggregate_id, topic, headers, payload FROM outbox
        WHERE published_at IS NULL ORDER BY id LIMIT 100 FOR UPDATE SKIP LOCKED`)
    if err != nil {
        return err
    }
    msgs, err := scan(rows)
    if err != nil || len(msgs) == 0 {
        return err
    }

    var done []uuid.UUID
    for _, m := range msgs {
        // at-least-once: падение между Publish и UPDATE → повтор → консумер отсечёт по event_id
        if err := Publish(ctx, r.kafka, m.Topic, m.AggregateID, m.Payload, m.Headers); err != nil {
            break // публикуем строго по порядку: на первой ошибке останавливаемся
        }
        done = append(done, m.ID)
    }
    if len(done) > 0 {
        if _, err := tx.Exec(ctx, `UPDATE outbox SET published_at = now() WHERE id = ANY($1)`, done); err != nil {
            return err
        }
    }
    outboxPending.Set(float64(len(msgs) - len(done)))
    return tx.Commit(ctx)
}
29. Консумер: ручной коммит, параллелизм по партициям, retry, DLQ
type Handler func(ctx context.Context, rec *kgo.Record) error

var (
    ErrRetryable = errors.New("retryable")
    ErrPermanent = errors.New("permanent")
)

func NewConsumer(brokers []string, group string, topics ...string) (*kgo.Client, error) {
    return kgo.NewClient(
        kgo.SeedBrokers(brokers...),
        kgo.ConsumerGroup(group),
        kgo.ConsumeTopics(topics...),
        kgo.ConsumeResetOffset(kgo.NewOffset().AtStart()),  // auto.offset.reset=earliest
        kgo.DisableAutoCommit(),                            // коммитим сами после обработки
        kgo.Balancers(kgo.CooperativeStickyBalancer()),     // инкрементальный ребаланс
        kgo.BlockRebalanceOnPoll(),                         // ребаланс ждёт конца обработки poll
        kgo.SessionTimeout(30*time.Second),
        kgo.InstanceID(os.Getenv("POD_NAME")),              // static membership: rolling update без ребаланса
        kgo.OnPartitionsAssigned(func(_ context.Context, _ *kgo.Client, m map[string][]int32) {
            slog.Info("partitions assigned", "map", m)
        }),
        kgo.OnPartitionsRevoked(func(_ context.Context, _ *kgo.Client, m map[string][]int32) {
            slog.Info("partitions revoked", "map", m)
        }),
    )
}

func RunLoop(ctx context.Context, cl *kgo.Client, h Handler, dlq *kgo.Client) error {
    for {
        fetches := cl.PollRecords(ctx, 100) // ограничиваем батч → держим max.poll.interval
        if fetches.IsClientClosed() || ctx.Err() != nil {
            return nil
        }
        fetches.EachError(func(t string, p int32, err error) {
            slog.Error("fetch", "topic", t, "partition", p, "err", err)
        })

        var wg sync.WaitGroup
        fetches.EachPartition(func(p kgo.FetchTopicPartition) { // параллельно по партициям
            wg.Add(1)
            go func() {
                defer wg.Done()
                for _, rec := range p.Records {       // внутри партиции строго последовательно
                    if err := withRetry(ctx, h, rec); err != nil {
                        toDLQ(ctx, dlq, rec, err)
                    }
                }
            }()
        })
        wg.Wait()

        if err := cl.CommitUncommittedOffsets(ctx); err != nil { // коммит после обработки
            slog.Error("commit", "err", err)                     // повтор после рестарта — норма
        }
        cl.AllowRebalance() // парный вызов к BlockRebalanceOnPoll
    }
}

func withRetry(ctx context.Context, h Handler, rec *kgo.Record) error {
    backoff := 100 * time.Millisecond
    for attempt := 1; attempt <= 3; attempt++ {
        err := h(ctx, rec)
        if err == nil || errors.Is(err, ErrPermanent) {
            return err
        }
        jitter := time.Duration(rand.Int64N(int64(backoff / 2)))
        select {
        case <-time.After(backoff + jitter):
        case <-ctx.Done():
            return ctx.Err()
        }
        backoff *= 2
    }
    return fmt.Errorf("%w: retries exhausted", ErrRetryable)
}

func toDLQ(ctx context.Context, dlq *kgo.Client, rec *kgo.Record, cause error) {
    out := &kgo.Record{
        Topic: rec.Topic + ".dlq", Key: rec.Key, Value: rec.Value,
        Headers: append(rec.Headers,
            kgo.RecordHeader{Key: "error", Value: []byte(cause.Error())},
            kgo.RecordHeader{Key: "original_topic", Value: []byte(rec.Topic)},
            kgo.RecordHeader{Key: "original_partition", Value: []byte(strconv.Itoa(int(rec.Partition)))},
            kgo.RecordHeader{Key: "original_offset", Value: []byte(strconv.FormatInt(rec.Offset, 10))},
        ),
    }
    if err := dlq.ProduceSync(ctx, out).FirstErr(); err != nil {
        slog.Error("dlq produce", "err", err) // не блокируем партицию из-за одного сообщения
    }
}
30. Идемпотентный обработчик
func (s *Service) HandleOrderPaid(ctx context.Context, rec *kgo.Record) error {
    var env eventsv1.Envelope
    if err := proto.Unmarshal(rec.Value, &env); err != nil {
        return fmt.Errorf("%w: unmarshal: %v", ErrPermanent, err)
    }
    ctx = otelx.ExtractTraceFromHeaders(ctx, rec.Headers) // продолжаем trace продюсера

    var ev eventsv1.OrderPaid
    if err := env.Payload.UnmarshalTo(&ev); err != nil {
        return fmt.Errorf("%w: payload: %v", ErrPermanent, err)
    }

    return s.db.Transaction(ctx, func(tx pgx.Tx) error {
        res, err := tx.Exec(ctx,
            `INSERT INTO processed_events (event_id) VALUES ($1) ON CONFLICT DO NOTHING`, env.EventId)
        if err != nil {
            return fmt.Errorf("%w: %v", ErrRetryable, err)
        }
        if res.RowsAffected() == 0 {
            duplicatesTotal.Inc()
            return nil // уже обработано
        }
        if _, err := tx.Exec(ctx, `UPDATE shipments SET status='ready' WHERE order_id=$1`, ev.OrderId); err != nil {
            return fmt.Errorf("%w: %v", ErrRetryable, err)
        }
        return nil
    })
}
31. Локальное окружение
services:
  kafka:
    image: apache/kafka:latest        # KRaft, без ZooKeeper
    ports: ["9092:9092"]
    environment:
      KAFKA_NODE_ID: 1
      KAFKA_PROCESS_ROLES: broker,controller
      KAFKA_CONTROLLER_QUORUM_VOTERS: 1@kafka:9093
      KAFKA_LISTENERS: PLAINTEXT://:9092,CONTROLLER://:9093
      KAFKA_ADVERTISED_LISTENERS: PLAINTEXT://kafka:9092
      KAFKA_CONTROLLER_LISTENER_NAMES: CONTROLLER
      KAFKA_OFFSETS_TOPIC_REPLICATION_FACTOR: 1
      KAFKA_AUTO_CREATE_TOPICS_ENABLE: "false"   # топики создаём явно, с нужными партициями
  kafka-ui:
    image: provectuslabs/kafka-ui:latest
    ports: ["8080:8080"]
    environment:
      KAFKA_CLUSTERS_0_NAME: local
      KAFKA_CLUSTERS_0_BOOTSTRAPSERVERS: kafka:9092
Создание топиков из кода (kadm):
adm := kadm.NewClient(cl)
_, err := adm.CreateTopics(ctx, 6 /*partitions*/, 1 /*RF*/, map[string]*string{
    "retention.ms":   kadm.StringPtr("604800000"), // 7 дней
    "cleanup.policy": kadm.StringPtr("delete"),
}, "orders.order.created", "orders.order.created.retry", "orders.order.created.dlq")
Часть VII. Эксплуатация
32. Что мониторить
| Метрика | Откуда | О чём говорит |
|---|---|---|
| Consumer lag по группе и партиции | kadm.Lag, kafka_exporter | главная метрика: не успеваем или упали |
| Перекос лага по партициям | то же | hot partition или зависший консумер на одной партиции |
outbox_pending | приложение | relay отстаёт или Kafka недоступна |
| Частота ребалансов | хуки OnPartitionsRevoked | rebalance storm |
| Размер DLQ | приложение | ядовитые сообщения, сломанный контракт |
| Produce latency p99 | kotel / клиент | перегрузка брокера, отставание ISR |
| Under-replicated / offline partitions | JMX брокера, exporter | реплика выпала из ISR: при acks=all пишем медленнее или падаем |
| Disk usage vs retention | node exporter | переполнение диска брокера = остановка кластера |
| Request handler idle % | JMX | брокер на пределе |
Инструменты: kafka_exporter + Prometheus/Grafana, Kafka UI / Redpanda Console / AKHQ для глаз, kafka-consumer-groups.sh --describe для быстрой диагностики, Cruise Control для балансировки партиций между брокерами.
Вопросы с собеседований
- Чем Kafka отличается от RabbitMQ? Лог против очереди: Kafka хранит, консумер тянет и держит оффсет, возможны replay и много независимых читателей; RMQ удаляет после ack, толкает, богатая маршрутизация.
- Что гарантирует порядок сообщений? Только партиция. Одинаковый ключ → одна партиция → порядок.
- Как выбрать ключ партицирования? ID сущности, чей порядок важен, при равномерном распределении. Иначе hot partition.
- Сколько делать партиций и можно ли изменить? Исходя из целевой пропускной способности и числа инстансов; увеличить можно (ломает порядок по ключам), уменьшить нельзя.
- Как не потерять сообщение? Продюсер:
acks=all,min.insync.replicas=2, RF=3, идемпотентность. Консумер: коммит после обработки. Приложение: outbox. - Как не обработать дважды? Никак на уровне брокера — at-least-once даёт дубли. Идемпотентный консумер:
processed_events(event_id)в одной транзакции с бизнес-эффектом. - Существует ли exactly-once? Только Kafka → Kafka через транзакции продюсера. Для Kafka → внешняя БД — effectively-once через идемпотентность.
- Что такое ISR и
min.insync.replicas? Реплики, догнавшие лидера; минимальное их число для успешной записи приacks=all. Ставить на единицу меньше RF. - Что такое ребаланс и чем опасен? Переназначение партиций; чтение останавливается; незакоммиченное придёт повторно; долгая обработка → rebalance storm. Смягчается
cooperative-sticky, static membership, маленькимmax.poll.records. - Разница
session.timeout.msиmax.poll.interval.ms? Первый — про heartbeat (живость процесса), второй — про время между вызовами poll (скорость обработки). Второй ловит «жив, но не справляется». - Что делать с «ядовитым» сообщением? Классифицировать ошибку: permanent → DLQ сразу, retryable → backoff → retry-topic → DLQ. Партицию навсегда не блокировать.
- Compaction vs delete? Compaction хранит последнее значение по ключу («состояние»), delete — поток событий за период.
- Зачем заголовки сообщений? Трассировка (
traceparent), тип и версия схемы, метаданные — доступны без десериализации payload. - Как масштабировать консумера? Партиции ↑, инстансы ↑ (не больше числа партиций), параллелизм по партициям, батч-обработка.
- Нужен ли Schema Registry? При многих командах и языках — да; в монорепе с protobuf достаточно
buf breakingв CI. - Почему Kafka быстрая? Последовательный I/O, page cache, zero-copy (
sendfile), батчинг со сжатием, pull-модель. - Зачем KRaft вместо ZooKeeper? Одна система вместо двух, быстрее failover контроллера, выше потолок по числу партиций; в Kafka 4.x ZooKeeper удалён.
- Что такое retention и почему сообщение живёт дольше заявленного? Удаляются закрытые сегменты целиком, а не отдельные сообщения.
- Можно ли читать с реплики? С 2.4 — да, ближайший фолловер (rack awareness), ценой чуть менее свежих данных.
- Как сделать отложенную доставку? Нативного механизма нет — retry-topic с заголовком
retry_atи ждущим консумером.